如何通过监控与告警系统降低欧洲云计算机房着火风险的案例
2026年9月13日
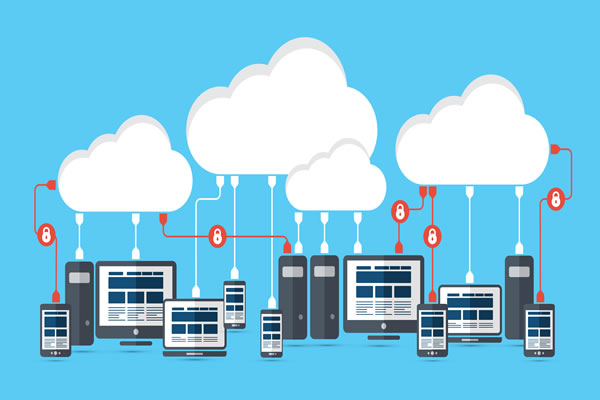
1. 概述:机房着火风险与云服务相关性
机房着火不仅是物理安全问题,也会导致服务器/VPS/主机服务中断。高负载(如DDoS攻击)会导致CPU/GPU温度持续升高,增加风险。
供电异常、UPS/发电机切换时的瞬时电流可能引发电气故障。
不当的散热布局或冷通道堵塞会使局部热斑形成。
因此,必须把监控与告警系统纳入云平台的日常运维体系中,才能有效降低风险。
2. 关键监测项与告警策略
温度:机柜入口温度(Inlet)>35°C预警,>45°C紧急告警并触发降载。湿度:相对湿度超过60%可能导致凝露或电气短路,需报警。
烟雾与光学/离子探测器:早期烟雾信号立即上报并触发录像回放。
电流/功率:PDU单口电流>80%额定值触发分流或负载移位。
告警联动:温度告警可通过API下发给CDN/负载均衡器,自动迁移流量或限制连接以降低服务器负载。
3. 技术实现:监控平台与自动化响应
采集层:使用IPMI、SNMP、Redfish与BMS(楼宇管理系统)统一采集传感器数据。存储与分析:时序数据库(如Prometheus/InfluxDB)保存监测点,Grafana用于可视化与热图。
告警引擎:基于Prometheus Alertmanager或商用NOC平台设置多级告警策略并支持SMS/邮件/语音。
自动化响应:当温度或电流异常时,通过API与负载均衡、CDN和防火墙联动,自动触发流量削峰(rate-limit)和实例迁移。
运维演练:定期演练(每季度)以验证监控链路、告警通知和自动化工单的有效性。
4. 真实案例:欧洲云运营商的演练与成果(匿名)
案例背景:某欧洲云服务商在荷兰机房进行一次真实演练,目标是测试监控告警对火灾早期响应的能力。发现过程:机柜A出现持续CPU负载激增(与DDoS模拟相关)并导致入口温度从30°C升至38°C。
系统响应:监控平台触发二级告警,同时自动调整CDN缓存策略并将部分流量移至邻近机房。
结果:通过流量迁移与分布式防护,单机负载下降50%,入口温度在10分钟内恢复至32°C,避免了进一步升温和电气风险。
总结:演练证明监控+自动化的联动能在不启动灭火系统前消除大部分风险。
5. 服务器与机柜配置示例(用于演练与预防)
机架服务器示例:2 x Intel Xeon Silver 4214, 128GB DDR4, 2 x 1.92TB NVMe, RAID1, 10GbE双口冗余。电源与散热:双路2000W冗余电源,机柜冷通道侧安装温度/湿度探头及风速传感器。
UPS与PDU:N+1 UPS,PDU支持每口电流监测,自动断路/分配策略。
网络防护:前端使用全球CDN、边缘WAF与DDoS防护,攻击流量在边缘被清洗后才进入核心机房。
运维策略:关键服务器开启IPMI和Redfish并上报到中央监控,阈值与自动化脚本记录在版本控制中。
6. 示例监测数据表(演示实时告警触发条件)
| 监测项 | 阈值 | 当前值 | 状态 |
|---|---|---|---|
| 机柜A入口温度 | 35°C(预警) / 45°C(紧急) | 38°C | 预警 — 降载中 |
| PDU口电流 | 80%额定 | 72%(正常) | 正常 |
| 机房烟雾探测 | 触发/未触发 | 未触发 | 正常 |
| 单机CPU利用率(平均) | 90%(持续5min)告警 | 82% | 接近阈值 |
| 外部流量(入站) | 1.2Gbps(基线) | 2.8Gbps | 异常 — 已触发DDoS清洗 |
相关文章
-

市场分析欧洲拖拉机房车品牌口碑与售后网络分布比较
1. 研究目标与范围定义 1) 明确目的:对比欧洲市场中拖拉机与房车两个细分市场的品牌口碑与售后网络覆盖,得出可执行结论。 2) 范围设定:选择国家(如德国、法国、英国、意大利、西班牙及东欧若干国),品牌清单(主流厂商+本地热门品牌),时间窗口(过去3年)。 3) 核心指标:NPS/净推荐值、在线评分(平均星级)、评价数量、售后服务点密度(每12026年9月11日 -
荷兰猪使用的是哪种服务器?
荷兰猪使用的是哪种服务器? 荷兰猪是一种特殊的猪种,因其肉质鲜嫩、多汁而备受烹饪爱好者的喜爱。然而,很多人对于荷兰猪养殖的细节并不了解,其中一个问题是:荷兰猪使用的是哪种服务器? 在现代养殖业中,服务器扮演着重要的角色。服务器是一台用于存储和处理数据的计算机设备,可以提供各种功能和服务。对于荷兰猪养殖来说,服务器起到了至关重要的作用。2025年3月17日 -
地铁逃生:欧洲服务器性能如何?
地铁逃生:欧洲服务器性能如何? 地铁逃生是一款备受欢迎的生存游戏,玩家需要在地铁隧道中逃生并避开各种危险。对于欧洲玩家来说,服务器的性能是至关重要的。本文将探讨欧洲服务器的性能如何,以及对玩家体验的影响。 欧洲地区拥有众多地铁逃生的玩家,因此服务器的性能至关重要。欧洲服务器的性能主要受到以下几个因素的影响: 服务器的2025年6月26日 -

欧洲站服务器台机的优势与选择指南
在当今数字化时代,选择合适的服务器对于网站的性能和用户体验至关重要。尤其是对于希望在欧洲市场展开业务的企业来说,选择一台适合的欧洲站服务器显得尤为重要。本文将介绍欧洲站服务器的优势,并提供选择指南,帮助您做出明智的决策。 首先,了解什么是欧洲站服务器。欧洲站服务器通常指的是在欧洲地区数据中心托管的服务器,这些服务器能够为用户提供2025年12月15日 -
英国签证邮箱服务器异常解决方法
英国签证是许多人梦寐以求的机会,然而,在申请过程中,有时会遇到邮箱服务器异常的问题。本文将介绍一些常见的邮箱服务器异常情况,并提供解决方法,帮助申请者顺利处理签证申请。 1. 邮件发送失败 在发送签证申请相关的邮件时,有时会收到发送失败的通知。这可能是由于邮箱服务器设置的限制导致的。为了解决这个问题,可以尝试以下方法: 检查邮件地2025年3月29日 -
英国黑客服务器清单
英国黑客服务器清单 在网络世界中,黑客服务器是那些被黑客用来进行非法活动的服务器。这些服务器通常位于各个国家,其中包括英国。本文将介绍一些在英国发现的黑客服务器清单。 服务器A位于英国伦敦市中心,由一群黑客组成的团队经营。他们利用该服务器进行网络钓鱼、网络攻击和非法访问等活动。该服务2025年4月23日 -

收藏级图片推荐 欧洲拖拉机房车图片大全中不可错过的机型
判断一张图片是否为收藏级图片,关键看两点:一是图像本身的稀缺性(限量拍摄、历史车型或特殊改装);二是画质与信息量(高分辨率、构图与细节展示)。在浏览欧洲拖拉机房车图片大全时,优先关注带有车牌年份、厂牌标识或改装证书的照片,这类图像更具收藏与研究价值。 评估时可按画质(分辨率与清晰度)、信息量(侧面/底盘/内饰细节)、来源可靠性(拍摄者/展会/经销档2026年6月21日 -
“French Server English Names: Unveiling the Essentials”
French Server English Names: Unveiling the Essentials In the online gaming world, players often come across servers with different names. These names can vary from reg2025年2月25日 -
荷兰高速服务器:快速、可靠的网络连接体验
荷兰高速服务器:快速、可靠的网络连接体验 在当今数字化时代,网络连接的速度和可靠性对于个人和企业来说至关重要。荷兰高速服务器以其快速、可靠的网络连接体验而备受推崇。本文将深入探讨荷兰高速服务器的特点和优势。 荷兰高速服务器以其卓越的性能而广受赞誉。这些服务器采用最先进的技术和设备,具有强大的处理能力和高速的数据传输速度。无论是2025年3月29日